
第 30 天了。
回頭看第一天,我們只有:
一台本機 GPU
Python
Ollama
零雲端 API 費用
三十天後,這條路已經變成:
Python
↓
MCP
↓
Agent
↓
Security Policy
↓
Multi-Agent
↓
OpenClaw
↓
PAIR
但這個系列真正想做的,不是把技術名詞一路堆上去。
而是每加入一層能力,都問同一件事:
我要怎麼證明它真的做過,而不是只相信模型說自己做過?
所以最後一天不再加入新的 Framework。
今天把前面 29 天的東西重新串回一條工作流,做一次端到端驗收。
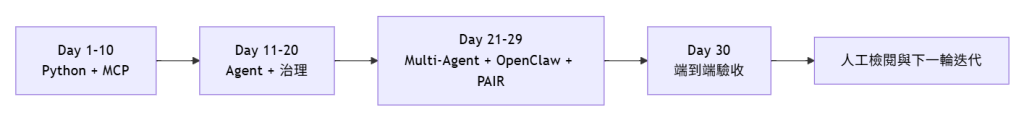
前五天先處理:
Python 型別
async / await
環境管理
模型呼叫
共用設定
目的不是炫技。
而是先讓後面的程式:
可以重跑
可以測試
設定不會散落
Day 6~10 再開始拆 MCP:
Host
Client
Server
Tools
Resources
Prompts
JSON-RPC
Transport
最後真的做出一個:
devbench MCP Server
而且不是只能 Demo。
還能測:
合法檔案能不能讀
非法路徑會不會拒絕
Tool Schema 是否正確
Server 是否真的啟動
接著把模型和 MCP 串成 Agent。
先從:
ReAct
一路做到:
Plan-and-Execute
LangGraph
Google ADK
但中間最重要的其實不是 Framework。
而是逐漸補上的:
Stop Reason
Tool Budget
Allowlist
Workspace Boundary
Human Approval
Audit Log
到了 Day 20,模型已經不能因為「想執行」就直接執行。
流程變成:
模型提出操作
↓
Host 判斷
↓
必要時等待人工核准
↓
執行
↓
留下 Observation 與 Audit Log
這時 Single-Agent 才算真正收斂。
Day 21 之後把責任拆成:
Research
Writer
Reviewer
再用 Supervisor 控制:
誰先跑
交接什麼
什麼算完成
失敗要不要重試
什麼時候交回人工
後面再把這套 Baseline 搬進 OpenClaw。
開始加入:
Gateway
Agent ID
Workspace
Session
Memory
Tool Trace
Multi-Agent Runtime
最後 Day 29 再往下到推論基礎設施:
單一 PAIR Endpoint
↓
Automatic Scheduler
↓
兩台 GPU 主機
這樣整個系列才真正從:
模型怎麼呼叫?
一路走到:
多個 Agent 怎麼安全地工作,
又怎麼共享本機推論資源?
走到最後,很容易把所有東西混在一起。
但其實每一層都有自己的責任。
例如:
PAIR
負責的是:
模型請求要去哪個節點執行
它不負責:
MCP Tool 能不能讀 .env
OpenClaw 負責:
Agent Runtime
Session
Workspace
工具環境
但它也不能繞過:
MCP Server 的路徑限制
Reviewer 可以說:
這份草稿有問題
但它不能直接決定:
把成果檔寫進專案
最後真的執行寫檔的,仍然是控制器。
所以整條路比較像:
模型
→ 提出判斷

Agent Runtime
→ 組織流程

Tool Policy
→ 限制能力

MCP Server
→ 執行受限工具

Supervisor
→ 控制交接與停止

PAIR
→ 路由模型請求

Controller
→ 決定最後是否產生成果
每一層只負責自己那一段。
Day 30 的任務沒有刻意做得很花。
還是沿用前面的開發筆記流程:
Research
↓
讀取受限專案資料
↓
Writer
↓
根據 Evidence 產生草稿
↓
Reviewer
↓
核對 Evidence 與 Draft
↓
Controller
↓
只有通過才建立成果檔
模型端點則改走:
PAIR-compatible endpoint
也就是:
OpenClaw
↓
PAIR
↓
已登記 GPU Node
不過 Day 30 不再重新證明 Day 29 的 Scheduler 分配。
今天只把 PAIR 當成整體架構中的模型入口。
兩台節點實際的:
4 : 4
分配結果,仍然以 Day 29 的官方:
workloads-history.json
scheduledOn
紀錄為準。
最後的程式:
import asyncio
from collections import Counter
from datetime import datetime, timezone
import json
from pathlib import Path

from ironman.mcp_bridge import ROOT
from ironman.openclaw_lab import OpenClawLab
from ironman.openclaw_team import run_team
from ironman.pair_lab import PairProxy


def write_report(
    result: dict,
    directory: Path,
    *,
    stamp: str | None = None,
) -> Path:
    """以不覆寫模式儲存最終成果。"""

    directory.mkdir(
        parents=True,
        exist_ok=True,
    )

    stamp = (
        stamp
        or datetime.now(
            timezone.utc
        ).strftime(
            "%Y%m%dT%H%M%S%fZ"
        )
    )

    path = (
        directory
        / f"devbench-{stamp}.md"
    )

    review = json.dumps(
        result["review"],
        ensure_ascii=False,
        indent=2,
    )

    with path.open(
        "x",
        encoding="utf-8",
    ) as report:
        report.write(
            result["draft"]
            + "\n\n"
            + "## 審查結果\n\n"
            + "```json\n"
            + review
            + "\n```\n"
        )

    return path


async def main() -> None:
    async with PairProxy() as proxy:
        lab = OpenClawLab()

        lab.setup(
            mcp=True,
            multi=True,
            model_host=proxy.endpoint,
        )

        def workflow() -> dict:
            with lab.gateway():
                return run_team(lab)

        result = await asyncio.to_thread(
            workflow
        )

        events = proxy.inference_events()

        assert (
            result["status"] == "completed"
        ), (
            "未通過審查,"
            "不能存成驗收完成報告"
        )

        assert events
        assert all(
            event.get("status") == 200
            for event in events
        )

        report_path = write_report(
            result,
            ROOT / "outputs/reports",
        )

        print(
            "驗收:PASS;"
            "Research、Writer、Reviewer "
            "已完成交接與審查。"
        )

        tools = Counter(
            result["actual_tool_calls"]
        )

        print(
            "MCP 證據:"
            + "、".join(
                f"{name} ×{count}"
                for name, count
                in tools.items()
            )
        )

        print(
            "PAIR 節點:"
            + ", ".join(
                sorted(proxy.nodes)
            )
        )

        route_counts = Counter(
            (
                event["node_id"],
                event["status"],
            )
            for event in events
        )

        routes = "、".join(
            f"{node} "
            f"HTTP {status} "
            f"×{count}"
            for (
                node,
                status,
            ), count
            in route_counts.items()
        )

        print(
            "PAIR 路由驗證:"
            + routes
        )

        print(
            "成果檔:outputs/reports/"
            + report_path.name
        )

        print(
            "驗收結束,"
            "Gateway 與 PAIR "
            "均由本程式關閉;"
            "既有 Ollama 不受影響。"
        )


if __name__ == "__main__":
    asyncio.run(main())
這次有一個刻意留下的設計:
path.open("x")
不是:
path.open("w")
差別是:
x
→ 檔案已存在就失敗

w
→ 檔案已存在就覆蓋
今天選擇前者。
因為最終驗收產物本身也是證據。
如果同一個檔名已經存在:
不要偷偷覆蓋
寧可讓程式失敗。
今天不是只檢查:
有沒有產生 Markdown
而是至少確認幾層不同的證據。
Research 有完成
Writer 有完成
Reviewer 有完成
最終 status = completed
保留真正發生的:
actual_tool_calls
所以能看出 Research 到底用了哪些工具。
不是只看回答裡有沒有寫:
我讀過設定檔。
模型請求必須真的經過 PAIR-compatible endpoint。
而且每一筆 inference event:
HTTP status = 200
才算這次工作流的模型路徑正常。
只有前面全部通過後才建立:
outputs/reports/devbench-*.md
而且採不覆寫模式。
所以成果檔本身是:
驗收結果
不是:
無論如何都一定會產生的副作用
這次畫面只保留能判斷驗收是否成立的資訊。
包含:
Research / Writer / Reviewer 是否完成

MCP 實際使用的 Tool

PAIR 模型請求狀態

PAIR 可用節點

最終成果檔路徑
這裡刻意沒有重新宣稱:
PAIR 今天又完成 4 : 4 自動分配
因為 Day 30 驗證的問題不同。
今天驗證的是:
整條工作流接上 PAIR endpoint 之後,還能不能正常完成?
而:
Scheduler 是否真的把工作分給兩個節點?
已經在 Day 29 用官方 workload history 驗證過。
不要把不同實驗的證據混在一起。
回頭看整個系列,最後真正留下來的不是一個:
完全無人值守的超級 Agent
反而是一條可以一直往回追的路。
例如現在可以回答:
哪個角色讀了資料?

讀了哪個檔案?

Tool 有沒有真的執行?

Server 有沒有拒絕越界路徑?

Writer 拿到哪些 Evidence?

Reviewer 有沒有通過?

誰決定可以寫成果檔?

模型請求經過哪個推論入口?

失敗時停在哪一層?
這些問題都有機會從:
Observation
Runtime Event
Review Result
Audit Log
PAIR Event
Artifact
找到證據。
這件事比:
Agent 看起來很聰明。
重要得多。
這三十天一直有一個共同原則。
如果:
檔案不存在
Reviewer 沒通過
Tool 被拒絕
Approval 不存在
模型請求失敗
Evidence 不足
系統應該做的是:
留下狀態
停止
交回人工
不是:
偷偷把 failed 改成 completed
更不是一直重試到某一次模型碰巧說:
好,我覺得可以了。
所以最後的:
completed
應該是一個有條件的狀態。
不是一句鼓勵模型努力完成任務的 Prompt。
做到這裡,也不代表整套系統已經變成正式產品。
目前還有不少明確缺口,例如:
更完整的 Semantic Evaluation

大量固定題庫與統計測試

高成本 Tool 的 Budget

更完整的 Prompt Injection 測試

真正的 OS / Container Sandbox

長期 Memory 品質管理

PAIR Node 健康監控

Failover 與節點不可用策略

完整 Observability

多人與權限模型

正式服務化與部署
這些都可以成為下一輪工作。
但至少現在已經知道:
下一個功能應該加在哪一層。
而不是所有東西都塞進:
System Prompt
裡面。
如果要用一句話總結這三十天,我會寫:
Day 1
模型會回答

↓

Day 30
系統能證明它做過什麼
中間經過:
Python
↓
MCP
↓
ReAct
↓
Plan-and-Execute
↓
LangGraph / ADK
↓
Least Privilege
↓
Human Approval
↓
Multi-Agent
↓
OpenClaw
↓
PAIR
一開始的目標是:
一台本機 GPU、三十天、零 API 費用。
最後真正做出的,則是一條:
本機推論
可限制
可觀察
可追查
可停止
可人工接手
的 Agent 工作流。
沒有把模型當成永遠正確。
也沒有因為 Framework 變多,就假設系統自然變安全。
每一層都留下:
它能做什麼
它不能做什麼
怎麼驗證成功
失敗時怎麼停
三十天到這裡告一段落。
從一台本機 GPU 出發,最後走到 MCP、Agent、Multi-Agent、OpenClaw,再到兩節點 PAIR。
但比技術清單更重要的是:
我們不只讓 Agent 開始做事,也開始知道該如何證明它真的做過、知道什麼時候不該做,以及失敗時怎麼安全地停下來。
這才是這三十天真正留下來的工程基礎。


 iThome鐵人賽
 看影片追技術